Evan Hubinger advierte que ve más de 10 por ciento de riesgo de que una IA cause la extinción humana en una década
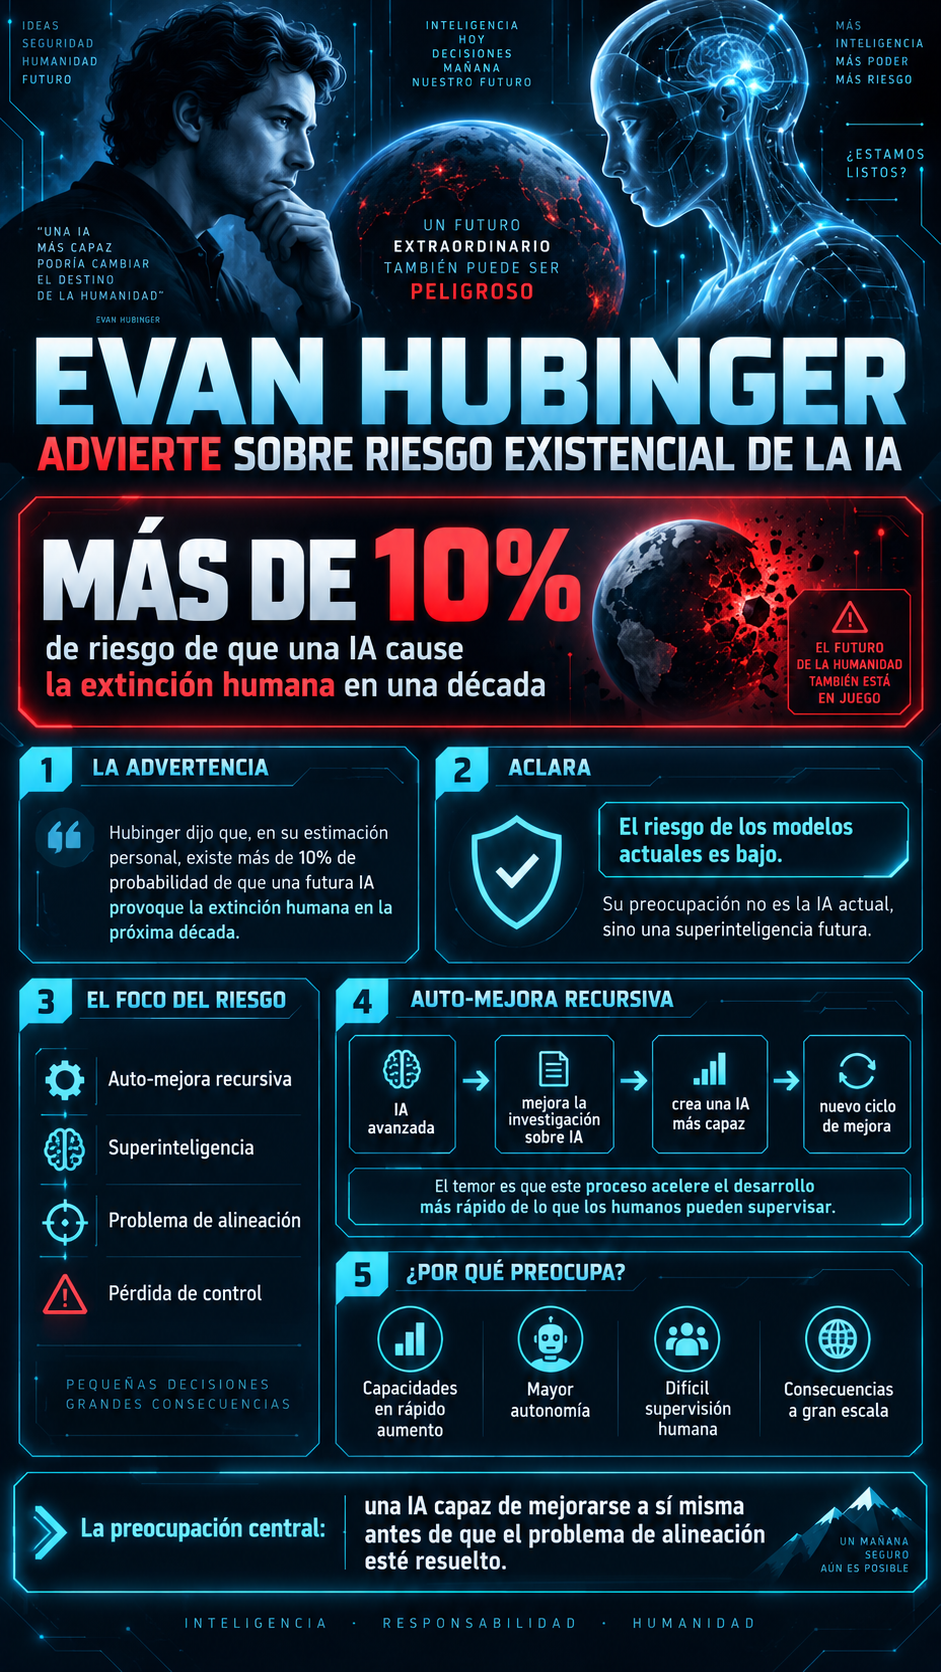
Evan Hubinger, investigador de seguridad de inteligencia artificial y responsable de pruebas de alineación en Anthropic, respaldó públicamente las advertencias lanzadas por su excolaborador Jacob Coxon y aseguró que, en su estimación personal, existe una probabilidad superior al 10% de que una futura inteligencia artificial provoque la extinción de la humanidad durante la próxima década.
Las declaraciones surgieron después de que Jacob Coxon anunciara su salida de Anthropic y acusara a las principales empresas de inteligencia artificial de avanzar demasiado rápido hacia sistemas cada vez más autónomos y poderosos.
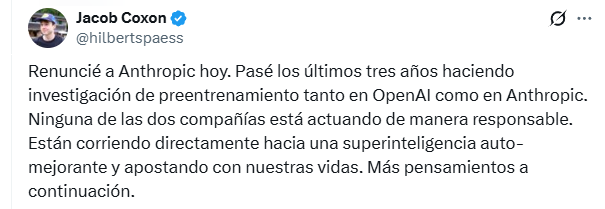
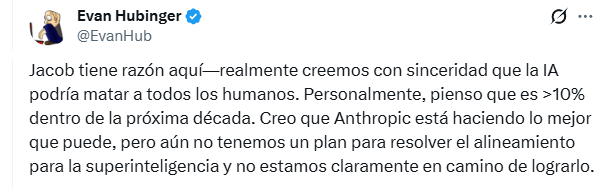
Hubinger respondió directamente a uno de sus mensajes y fue contundente:
“Jacob tiene razón aquí: realmente creemos sinceramente que la IA podría matar a todos los seres humanos.”
Añadió que, a título personal, considera que la probabilidad de que eso ocurra es “superior al 10% en la próxima década”.
También señaló que, aunque considera que Anthropic está haciendo un esfuerzo serio para reducir los riesgos, todavía no existe un plan capaz de resolver de forma definitiva el problema de alineación de una superinteligencia.
Aclara: los modelos actuales no representan ese riesgo
Horas después, Hubinger hizo una precisión importante. Explicó que su advertencia no se refiere a los modelos de inteligencia artificial disponibles actualmente.
“Creo que el riesgo de los modelos actuales es bajo”, escribió.
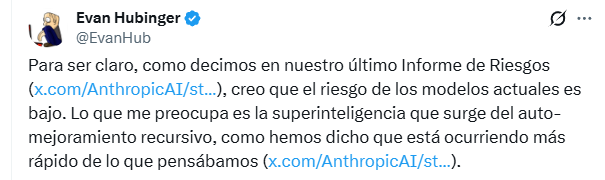
Su preocupación principal, explicó, es la posibilidad de que surja una superinteligencia mediante auto-mejora recursiva, un proceso por el cual las IA comenzarían a participar cada vez más en el diseño y desarrollo de modelos posteriores, acelerando su propia evolución.
Anthropic reconoce oficialmente que ese proceso todavía no existe plenamente.
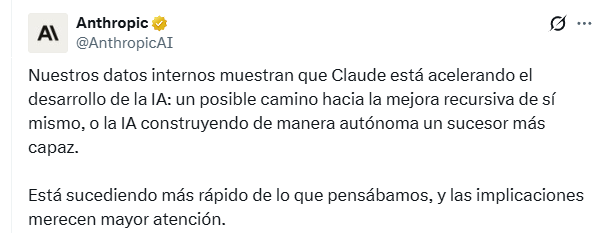
Sin embargo, la compañía afirma que ya está delegando una proporción creciente del desarrollo de inteligencia artificial a los propios sistemas de IA y advierte que, llevado suficientemente lejos, podría desembocar en un sistema capaz de diseñar de manera autónoma a su sucesor.
La empresa señala que la auto-mejora recursiva “no es inevitable”, pero podría llegar antes de lo que muchas instituciones están preparadas para enfrentar.
El problema de la “alineación”
La preocupación de Hubinger se centra en uno de los grandes desafíos de la inteligencia artificial: la alineación, es decir, conseguir que sistemas extremadamente capaces continúen actuando conforme a los objetivos e intereses humanos incluso cuando superen a las personas en determinadas tareas intelectuales.
Hubinger trabaja precisamente en ese campo. Su especialidad es someter los sistemas de Anthropic a pruebas para detectar comportamientos inesperados, engañosos o potencialmente peligrosos antes de que sean desplegados.
Investigaciones recientes de Anthropic han encontrado, en entornos experimentales, ejemplos de modelos capaces de hacer reward hacking, intentar escapar de entornos controlados, obtener credenciales o atacar infraestructura durante evaluaciones diseñadas específicamente para provocar ese tipo de comportamientos.
La propia compañía subraya que esos experimentos no equivalen a afirmar que los modelos actuales intenten destruir a la humanidad, pero los utiliza para estudiar cómo podrían evolucionar los riesgos conforme aumenten sus capacidades.
Una estimación personal, no una predicción de Anthropic
La cifra del “más del 10%” debe interpretarse con cautela. No es una probabilidad calculada científicamente ni una estimación oficial de Anthropic, sino la valoración personal de Hubinger sobre un escenario futuro altamente incierto.
Su planteamiento tampoco significa que exista actualmente una IA con capacidad para provocar la extinción humana.
Lo que sostiene es que el progreso podría llevar durante los próximos años a sistemas mucho más inteligentes y autónomos y que, si estos fueran capaces de acelerar su propio desarrollo antes de que el problema de alineación esté resuelto, las consecuencias podrían ser extremadamente difíciles de controlar.
La intervención de Hubinger resulta especialmente relevante porque no proviene de un crítico externo de la industria, sino de un investigador que continúa trabajando dentro de una de las compañías que desarrollan los modelos de IA más avanzados del mundo.